Alertas analíticas: cómo detectar anomalías antes de perder ventas
Las alertas analíticas son notificaciones automáticas que avisan sobre cambios anómalos en métricas, errores de implementación en GA4 o Google Tag Manager y caídas de conversión. El enfoque correcto no es acumular avisos, sino priorizar precisión, asignar un responsable a cada tipo de alerta y vigilar indicadores líderes antes de que el problema llegue a los ingresos. Hecho así, el resultado es una detección más rápida y menos ruido operativo.
En resumen:
- La detección de anomalías en métricas críticas requiere priorizar alertas por criticidad y asignar responsables claros para evitar el ruido operativo.
- GA4 es eficiente para detectar desviaciones sostenidas, pero su retraso en datos intradiarios limita su utilidad en casos urgentes como caídas en checkout o pagos.
- Monitorizar varias capas, desde eventos específicos en GTM hasta propiedades de etiquetas y parámetros, permite identificar problemas silenciosos que afectan la atribución y la medición.
- La integración de herramientas como
addEventCallbacken GTM facilita detectar fallos en la ejecución de etiquetas, enviando métricas a endpoints externos para alertas independientes.- Implementar un proceso de confirmación, documentación y ajuste continúo en las alertas ayuda a reducir falsos positivos y mejorar la respuesta del sistema de monitorización.
Tabla de contenidos
- Qué capas debe cubrir un sistema de alertas analíticas
- Qué no detecta bien GA4 (y cuándo necesitas algo más)
- Cómo monitorizar Google Tag Manager con addEventCallback
- Cómo diseñar alertas que generan acción, no ruido
- Checklist para implementar alertas analíticas efectivas
- Referencia rápida por tipo de alerta
- Conclusiones: prioridades y plan de 30/60/90 días
- Ejemplos de alertas analíticas según el sector
- Cómo conectar tus alertas con Slack, correo o SMS
- Herramientas más allá de GA4 para alertas avanzadas
- Cómo cerrar el ciclo: de la alerta a la mejora continua
- Lo que aprendimos auditando implementaciones reales
- Cómo LG DataOne automatiza la detección y priorización de alertas
- Fuentes
- Preguntas frecuentes
Qué capas debe cubrir un sistema de alertas analíticas
Un sistema de alertas analíticas completo no vigila solo la métrica final. Vigila toda la cadena: desde el dataLayer hasta el informe agregado que ve el equipo de marketing. Si solo revisas el total de ingresos, puedes pasar por alto que un segmento entero de usuarios de Android dejó de reportar eventos de compra durante seis horas.
Existe una diferencia clave entre alertas agregadas (ingresos totales, sesiones totales) y alertas a nivel de dimensión o parámetro (ingresos por canal, tasa de error por dispositivo, valor de un parámetro específico del evento purchase). Las primeras detectan que algo va mal; las segundas dicen exactamente dónde.
Antes de disparar cualquier alerta hay que validar la fuente. Un pico falso puede originarse en un cambio de esquema del dataLayer, no en un problema real de negocio.
Las capas que conviene monitorizar son:
- Métrica de negocio: ingresos, transacciones, leads, suscripciones activas.
- Dimensión o segmento: canal, dispositivo, país, categoría de producto.
- Parámetro o evento de colección: valores de
transaction_id,currency,item_iddentro del evento. - Estado de la etiqueta: si el tag se disparó, con qué latencia y con qué metadatos.
Muchos fallos solo son visibles en la capa de parámetros: un GTM que sigue disparando el evento purchase pero con transaction_id vacío pasa desapercibido en el informe agregado, aunque esté corrompiendo la atribución de campañas.
Qué no detecta bien GA4 (y cuándo necesitas algo más)
GA4 detecta anomalías con un modelo bayesiano que compara el valor actual de una métrica contra su comportamiento histórico esperado. Funciona razonablemente bien para detectar desviaciones sostenidas en métricas ya establecidas, como una caída de sesiones o de ingresos durante varios días.
El problema está en los plazos. La detección diaria de GA4 puede requerir hasta 90 días de histórico para entrenar el modelo, y el procesamiento de datos recientes puede tardar entre 24 y 48 horas.
Dato clave: una anomalía intradiaria, como una caída de checkout durante una campaña breve, puede quedar totalmente fuera del radar de GA4 hasta el día siguiente, cuando ya es tarde para actuar.
Esta limitación no convierte a GA4 en una mala herramienta. Sigue siendo útil para alertas de criticidad media o baja, donde un retraso de un día no compromete ingresos. Pero para detección intradiaria y correlación entre fuentes distintas (anuncios, CRM, servidor), las guías de observabilidad recomiendan combinar la detección nativa con una capa adicional que no dependa de ventanas históricas largas.
Consejo profesional: reserva GA4 para alertas de Tier 2 o 3, donde el negocio tolera un día de retraso. Para Tier 1 (checkout, pagos, formularios críticos) necesitas una vía de detección casi en tiempo real.
Cómo monitorizar Google Tag Manager con addEventCallback
Google Tag Manager permite crear plantillas personalizadas con un callback llamado addEventCallback. Esta función devuelve el estado de ejecución de cada etiqueta: si se disparó correctamente, cuánto tardó y qué metadatos asociados tiene, como el nombre de la etiqueta o el grupo al que pertenece.
Ese dato tiene más valor cuando no se queda dentro de GTM. Enviarlo a un endpoint de monitorización separado, típicamente en la nube, evita que un fallo en la propia plataforma de analítica oculte el problema. Simo Ahava describe este patrón como el envío de eventos de monitorización hacia un endpoint en GCP, almacenados después en BigQuery para construir dashboards y reglas de alerta independientes.
El caso de uso más común: una etiqueta de conversión de Google Ads que sigue disparándose (GA4 recibe el evento) pero con un tiempo de ejecución que se multiplica por diez, síntoma de un contenedor sobrecargado o un conflicto de scripts. GA4 no muestra ninguna anomalía porque el volumen de eventos no cambia; solo el registro de executionTime la revela.
Las ventajas prácticas de este enfoque:
- Detectas etiquetas que fallan silenciosamente aunque el conteo total de eventos parezca normal.
- Puedes agrupar alertas por metadata (campaña, feature, grupo de tags) sin tocar el payload de cada etiqueta.
- El endpoint sigue funcionando aunque GA4 o GTM tengan una incidencia propia.
Consejo profesional: usa el campo de metadata de la plantilla para etiquetar cada tag con su “dueño” funcional (checkout, marketing, analítica). Así la alerta llega directamente al equipo correcto, sin triaje manual.
Cómo diseñar alertas que generan acción, no ruido
Una alerta sin dueño ni umbral claro se convierte en ruido que el equipo aprende a ignorar. El diseño operativo que funciona en la práctica se apoya en tres decisiones: clasificación por criticidad, puntuación de confianza y SLAs de respuesta.
- Clasifica por clase de criticidad. La Clase 1 cubre eventos que afectan ingresos de forma directa: checkout, pago, formulario de alta. La Clase 2 cubre métricas de calidad de datos que degradan la medición sin frenar la venta, como pérdida parcial de UTMs. La Clase 3 cubre desviaciones informativas, útiles pero no urgentes, como una caída moderada de sesiones orgánicas.
- Calcula un score de confianza. Combina el ajuste respecto a la baseline histórica, la magnitud de la desviación y si existen señales de soporte en otras fuentes (por ejemplo, el CRM confirma la misma caída). Los marcos operativos de triaje recomiendan filtrar por duración sostenida (cinco minutos para Clase 1, ventanas mayores para Clase 2 y 3) antes de notificar, para evitar picos puntuales sin relevancia.
- Define rutas y SLAs medibles. Cada clase necesita un propietario, un canal de notificación y un tiempo máximo de respuesta: por ejemplo, confirmación de recepción en 15 minutos para Clase 1, diagnóstico en una hora y acción en cuatro horas.
Sin esta estructura, un sistema técnicamente perfecto sigue fallando porque nadie sabe quién debe reaccionar ni en qué plazo.
Checklist para implementar alertas analíticas efectivas
Antes de escribir la primera regla de alerta, conviene hacer un inventario de qué métricas y eventos son realmente críticos para el negocio. No todas las conversiones pesan igual: una caída del 5 % en newsletter no exige la misma urgencia que una caída del 5 % en checkout.
Los pasos que marcan la diferencia en la práctica:
- Inventaría y prioriza los eventos críticos (compra, lead, suscripción) frente a los secundarios.
- Valida el esquema del
dataLayerde forma continua, no solo al lanzar la implementación; un cambio silencioso de un desarrollador rompe alertas sin avisar. - Prueba cada regla de alerta en staging antes de activarla en producción, simulando el evento que debería dispararla.
- Configura ventanas intradiarias para eventos Clase 1, sin depender de ciclos diarios de agregación.
- Reconcilia periódicamente contra una fuente de verdad (el pedido real en el ERP, la transacción en la pasarela de pago) para confirmar que la alerta refleja la realidad del negocio.
Para investigaciones puntuales sin recursos de análisis avanzado, un flujo simple funciona bien: define la métrica exacta, elige una baseline justa, comprueba la frescura de los datos en GA4, aísla el segmento afectado y corrobora con una fuente externa antes de concluir. Documentar el nivel de confianza de cada conclusión evita que una corazonada se trate como un hecho confirmado.
Referencia rápida por tipo de alerta
| Qué monitorizar | Frecuencia | Urgencia | Propietario sugerido |
|---|---|---|---|
| Caída de tasa de checkout | Intradiaria (cada 15-30 min) | Clase 1 (crítica) | CRO / e-commerce |
| Evento purchase sin transaction_id | En tiempo real | Clase 1 (crítica) | Analítica / desarrollo |
| Tiempo de carga de página | Diaria | Clase 2 (media) | Rendimiento / WPO |
| Pérdida de parámetros UTM | Diaria | Clase 2 (media) | Marketing / analítica |
Conclusiones: prioridades y plan de 30/60/90 días
La decisión clave es simple: prioriza precisión sobre volumen y asigna dueño a cada clase de alerta. En los primeros 30 días, haz el inventario de eventos críticos y valida el dataLayer. En 60 días, implementa monitorización de GTM con addEventCallback y define SLAs por clase. En 90 días, mide la calidad del sistema con dos indicadores: la precisión de las alertas (proporción de avisos que reflejan un problema real) y la latencia de decisión (tiempo entre la anomalía y la acción correctiva). Sin estas métricas, no sabrás si tu sistema mejora o solo genera más ruido.
Ejemplos de alertas analíticas según el sector
En e-commerce, la alerta más valiosa suele ser la caída de la tasa de checkout por dispositivo o método de pago. Una caída del 30 % en pagos con tarjeta durante una hora, mientras PayPal se mantiene estable, apunta casi siempre a un fallo del proveedor de pago, no a un problema de demanda.
En SaaS, las alertas críticas giran alrededor de la activación y el churn temprano: una caída repentina en el evento de “primer login exitoso” tras un despliegue suele señalar un error de onboarding, no una pérdida real de interés. También es común alertar sobre picos anómalos en errores de API que afectan al panel de control del cliente, porque suelen preceder a cancelaciones.
En medios y publishers, las alertas relevantes se centran en el tiempo de carga de página y en la pérdida de parámetros de campaña. Una caída del 20 % en sesiones desde un canal de referidos, combinada con un aumento del tiempo de carga en móvil, casi siempre indica un problema técnico (un script de terceros bloqueando el render) antes que una caída genuina de audiencia.
En los tres sectores se repite el mismo patrón: la alerta útil no describe solo “qué bajó”, sino “qué segmento, dispositivo o fuente concreta lo explica”. Una alerta que solo dice “las conversiones cayeron un 12 %” obliga a un analista a investigar durante horas. En cambio, una alerta que dice “las conversiones cayeron un 12 %, concentradas en Safari móvil, coincidiendo con el despliegue de las 14:00” permite actuar en minutos.
Cómo conectar tus alertas con Slack, correo o SMS
Una alerta detectada a tiempo pero encerrada en un panel que nadie revisa equivale a no tener alerta. La notificación tiene que llegar al canal que el equipo responsable ya usa a diario.
Para incidentes de Clase 1 (checkout, pagos, formularios críticos), el canal más eficaz suele ser una combinación de Slack y SMS: Slack para visibilidad del equipo completo, SMS o llamada automática para garantizar que el responsable de guardia reacciona aunque no esté mirando la pantalla. El correo electrónico, en cambio, funciona mejor para alertas de Clase 2 y 3, donde no se necesita una respuesta inmediata pero sí trazabilidad y un histórico consultable.
Por ejemplo, una alerta con metadata owner:pagos puede dirigirse automáticamente a un canal de Slack específico del equipo de pagos, mientras que una alerta owner:marketing llega por correo al equipo de adquisición.
Consejo profesional: evita mandar todas las alertas al mismo canal general. Un canal de Slack saturado de avisos de baja prioridad es la causa número uno de que el equipo empiece a ignorar también los avisos críticos.
La clave no es la herramienta de notificación en sí, sino la regla de enrutamiento detrás: qué clase va a qué canal, con qué SLA de respuesta asociado, y quién confirma que la alerta fue atendida.
Herramientas más allá de GA4 para alertas avanzadas
GA4 cubre bien la detección de anomalías agregadas con retraso de un día, pero no cubre monitorización de etiquetas, latencia de ejecución ni correlación entre fuentes distintas de datos. Ahí entran herramientas complementarias.
Tag Diagnostics, integrado en GTM, permite detectar problemas de calidad como etiquetas ausentes, IDs de transacción vacíos o bloqueos por política de seguridad de contenido (CSP), con ventanas de detección de hasta 48 horas. Es un buen primer filtro, pero sigue operando con retraso y dentro del propio ecosistema de Google.
Para monitorización más profunda, el patrón recomendado en la documentación técnica es construir un pipeline propio: capturar el estado de cada etiqueta con addEventCallback, enviarlo a un endpoint en la nube y almacenarlo en BigQuery para análisis y alertas independientes. Las guías de buenas prácticas de tags insisten en que esta separación evita que un fallo de la plataforma de analítica principal oculte el problema que se intenta detectar.
También hay proveedores especializados en construir la capa de ingestión de datos a medida, como Vetros, útiles cuando el volumen de eventos exige una arquitectura más robusta que un endpoint simple.
Cómo cerrar el ciclo: de la alerta a la mejora continua
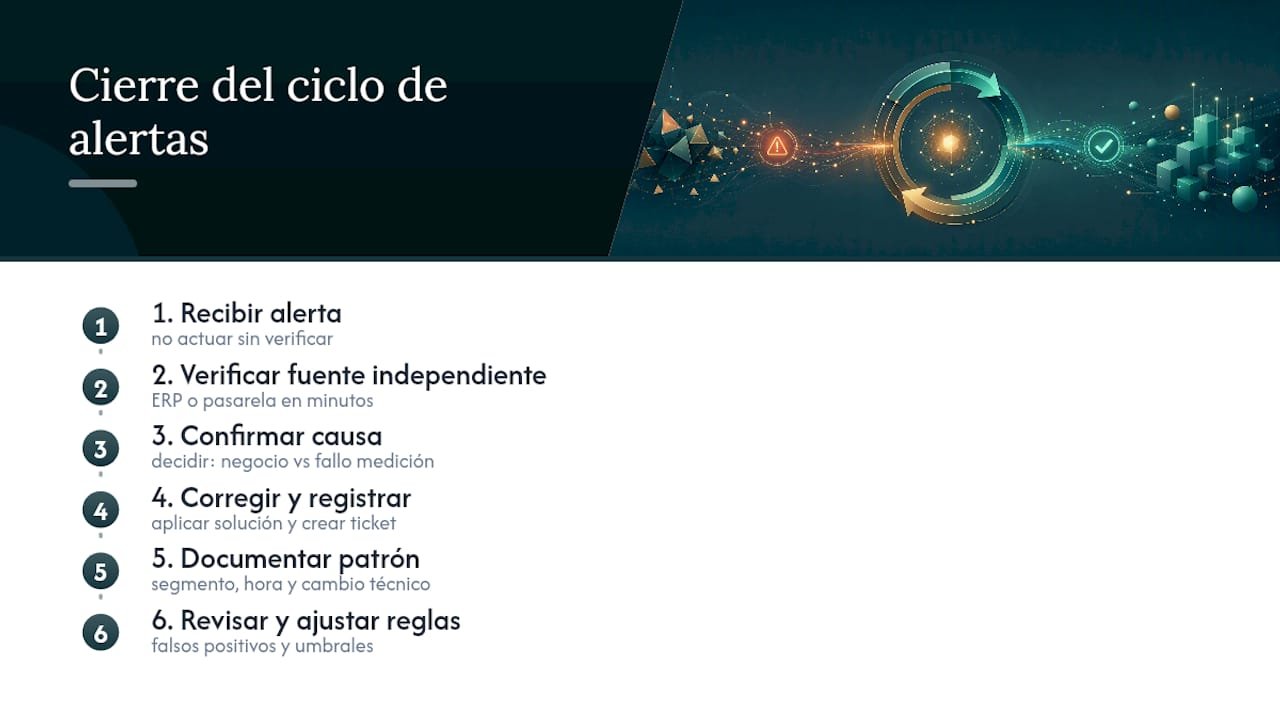
Detectar una anomalía es solo la mitad del trabajo. El ciclo se cierra cuando la alerta se traduce en una causa confirmada, una corrección aplicada y un ajuste del propio sistema de alertas para que el mismo problema no vuelva a generar ruido innecesario.
El primer paso al recibir una alerta es confirmar si es real antes de escalarla. Compara la métrica afectada contra una fuente independiente: si GA4 marca una caída de transacciones, el ERP o la pasarela de pago deben confirmar (o desmentir) esa caída en minutos. Si la fuente externa no corrobora el problema, probablemente sea un fallo de medición, no de negocio, y merece su propio ticket de corrección.
Una vez confirmada la causa, documenta el patrón: qué segmento, qué hora, qué cambio técnico coincidió. Esa documentación alimenta el score de confianza de futuras alertas similares, de modo que el sistema aprende a distinguir entre ruido y señal real con el tiempo.
Por último, revisa periódicamente las métricas de calidad del propio sistema de alertas: cuántas fueron falsos positivos, cuánto tardó el equipo en reconocerlas y cuánto tardó en actuar. Los marcos de triaje operativo coinciden en que la fatiga de alertas es la causa principal de que un sistema bien diseñado deje de usarse en la práctica. Ajustar umbrales, eliminar reglas que generan ruido recurrente y reforzar las que detectan problemas reales es lo que convierte una alerta puntual en un proceso de mejora continua.
Lo que aprendimos auditando implementaciones reales
Las prácticas descritas aquí, clasificación por tiers, scoring de confianza, endpoints de monitorización separados, no salieron de un manual teórico. Surgieron de auditar decenas de implementaciones de GA4 y GTM en proyectos reales de Lester Grow, donde los mismos problemas se repetían: alertas mal calibradas, dueños indefinidos y demasiada dependencia de la detección nativa.
Automatizar la auditoría y priorizar por impacto, en lugar de revisar contenedores manualmente cada vez, fue la respuesta natural a ese patrón repetido. LG DataOne nació de convertir ese proceso manual en una herramienta sistemática.
— Juan
Cómo LG DataOne automatiza la detección y priorización de alertas
Tutorial general de LG DataOne. Conoce el recorrido por LG DataOne antes de poner en práctica las recomendaciones de este artículo.
Configurar manualmente cada capa (validación de esquema, monitorización de GTM, scoring de confianza, rutas de notificación) exige tiempo que la mayoría de equipos de analítica y CRO no tiene disponible cada semana.
Durante el periodo de prueba puedes conectar tu cuenta de GA4 y tu contenedor de GTM para identificar posibles errores de implementación. Es el punto de partida más rápido para saber si tus decisiones de CRO se están apoyando en datos fiables o en ruido. Empieza la prueba gratuita desde la página de optimización de tasas de conversión y comprueba en cuántas horas identificas tu primera anomalía real.
Para seguir profundizando: consulta este artículo relacionado y visita la funcionalidad de LG DataOne vinculada a esta guía.
Fuentes
- Google Analytics Help — Anomaly detection
- Google Tag Manager — Monitoring (templates)
- Simo Ahava — Google Tag Manager monitor
- EcomToolkit — Ecommerce analytics anomaly triage (2026)
Preguntas frecuentes
¿Qué son exactamente las alertas analíticas?
Son notificaciones automáticas que avisan sobre cambios anómalos en métricas de negocio, errores de implementación en GA4 o GTM y caídas de conversión, antes de que el problema afecte a los ingresos.
¿Por qué GA4 no basta para detectar todas las anomalías?
GA4 usa un modelo bayesiano entrenado con hasta 90 días de histórico y puede tardar entre 24 y 48 horas en procesar datos recientes, lo que lo hace poco adecuado para incidentes intradiarios.
¿Cómo evito la fatiga de alertas en mi equipo?
Clasifica cada alerta por clase de criticidad, asigna un dueño claro y aplica filtros de duración sostenida antes de notificar, en lugar de avisar ante cualquier pico puntual.
¿Qué canal de notificación funciona mejor para alertas críticas?
Para incidentes de Clase 1 conviene combinar Slack (visibilidad de equipo) con SMS o llamada automática, mientras que el correo electrónico basta para alertas de menor urgencia.
¿Puede una herramienta automatizar la priorización de alertas?
Sí.